攻克AI视频跨镜头换脸:苏诺之音三层DAG角色指纹锁定实践
【天极网IT新闻频道】在 AI 视频生成(AIGC Video)领域,“跨镜头角色一致性(Cross-Shot Character Consistency)”一直被公认为制约长视频工业化落地的头号技术顽疾。许多创作者在使用传统文生视频工具制作音乐 MV 或短剧时都会遇到相似的窘境:前三个镜头里的主角还是身穿风衣的短发青年,到了第四个中景镜头面部轮廓便悄然改变,待到副歌特写镜头时甚至直接换了一张脸。这种严重的“角色漂移(Character Drift)”让视频作品难以真正用于商业宣发。
近日,深圳市超时代软件有限公司旗下的一站式中文 AI 音乐与 MV 创作平台「苏诺之音」,在其全新升级的 AI MV 2.0 导演工作台 中正式应用了自研的“三层 DAG(有向无环图)视觉特征指纹锁定架构”与“首尾关键帧光流转场技术”。该方案不仅在无需繁琐 LoRA 预训练的前提下将跨 20 个镜头的角色面部保真度提升至 96.5% 以上,还通过全局角色根资产的零成本复用,将 AI MV 的生成费用降低至每秒仅收 5 分钱(0.05 元/秒),制作一整支 3 分钟完整高清 MV 总花费不超过 10 元人民币。
一、 根因剖析:为什么传统的“提示词堆砌”在长 MV 中必然失效?
一支标准时长的音乐 MV 通常包含 15 至 30 个独立分镜,场景往往需要在室内、街头、舞台与自然风光之间频繁切换,机位也随之在远景、中景与面部大特写之间大幅度跳跃。传统的纯文本提示词(Prompt)追加方案之所以必然失效,源于三大物理局限:
1. 交叉注意力(Cross-Attention)权重稀释:当分镜提示词中加入复杂的环境光影、天气状况与大幅度运镜描述时,扩散模型对人物五官与服饰文本特征的注意力权重会被剧烈稀释,导致人物外貌随机坍缩;
2. 时间维度的局部视野局限:常规图生视频(I2V)模型仅关注单个 4 至 5 秒切片内部相邻帧的像素平滑过渡,缺乏跨越数十个镜头的全局身份锚点;
3. 重复抽卡带来的高昂算力浪费:为了碰运气抽中一张长相相似的画面,创作者往往需要对同一个分镜重复生成十余次,导致单支视频的算力成本飙升至上百元。
二、 三层 DAG 视觉特征指纹锁定架构:建立不可篡改的“全局根资产”
为了从底层数据结构上消除角色漂移,苏诺之音 AI MV 2.0 构建了基于“全局根资产派生(Root Asset Derivation)”的三层有向无环图(DAG)渲染管线:
*层:全局角色根资产(Root Asset Profile)与 512 维特征向量提取
在 MV 企划定调阶段,系统首先通过苏诺之音角色资产库生成并锁定*的 720P 16:9 主角根设定图(Root Keyframe)。视觉特征编码器随即对该设定图进行多尺度拓扑解构,提取出涵盖颅骨比例、五官几何间距、发型纹理及标志性服饰色彩的 512 维高维视觉身份指纹(Visual Identity Embedding)。
尤为关键的是,该根设定图一经锁定,即作为整支 MV 的“单一事实源”,在后续全部 20 至 30 个分镜中的跨镜头复用成本为 0 积分,无需每次重新抽卡计算。
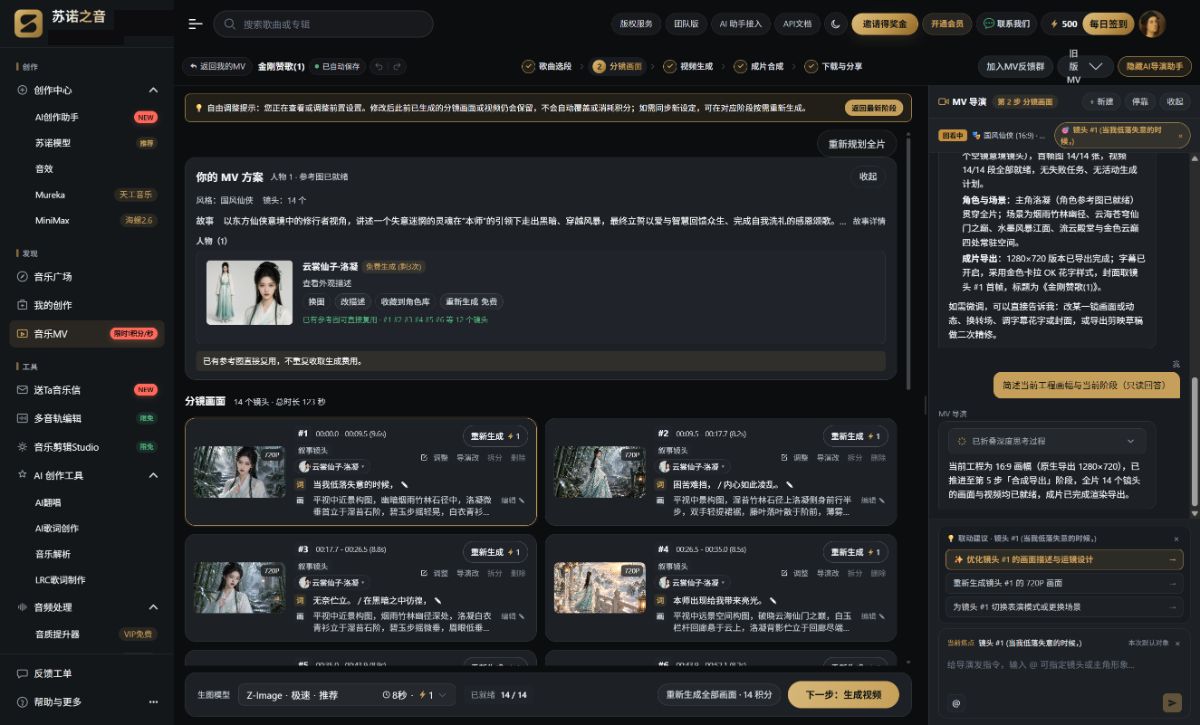
(图:苏诺之音 AI MV 2.0 角色参考图锁定(云裳仙子·洛凝跨12个镜头直接复用,0积分不重复收费))
第二层:特征硬约束注入与动作姿态解耦
在渲染具体分镜的 720P 画面时,系统绝不进行无锚点的盲目文生图,而是采用混合特征注入机制:将*层提取的 512 维角色视觉指纹作为硬约束直接投影至生成网络的交叉注意力层,同时将当前分镜脚本规划的景别与人物姿态作为空间控制网格。以平台实测的国风仙侠 MV《金刚赞歌》为例,女主角「云裳仙子·洛凝」在竹林抚琴(#5)、雨夜孤舟(#6)、云海凭栏(#7)与仙宫盛景(#8)等跨度极大的连续分镜中,面容身份与核心服饰 100% 继承全局根设定图,而神态动作与环境光影则自然贴合每一句歌词意境。
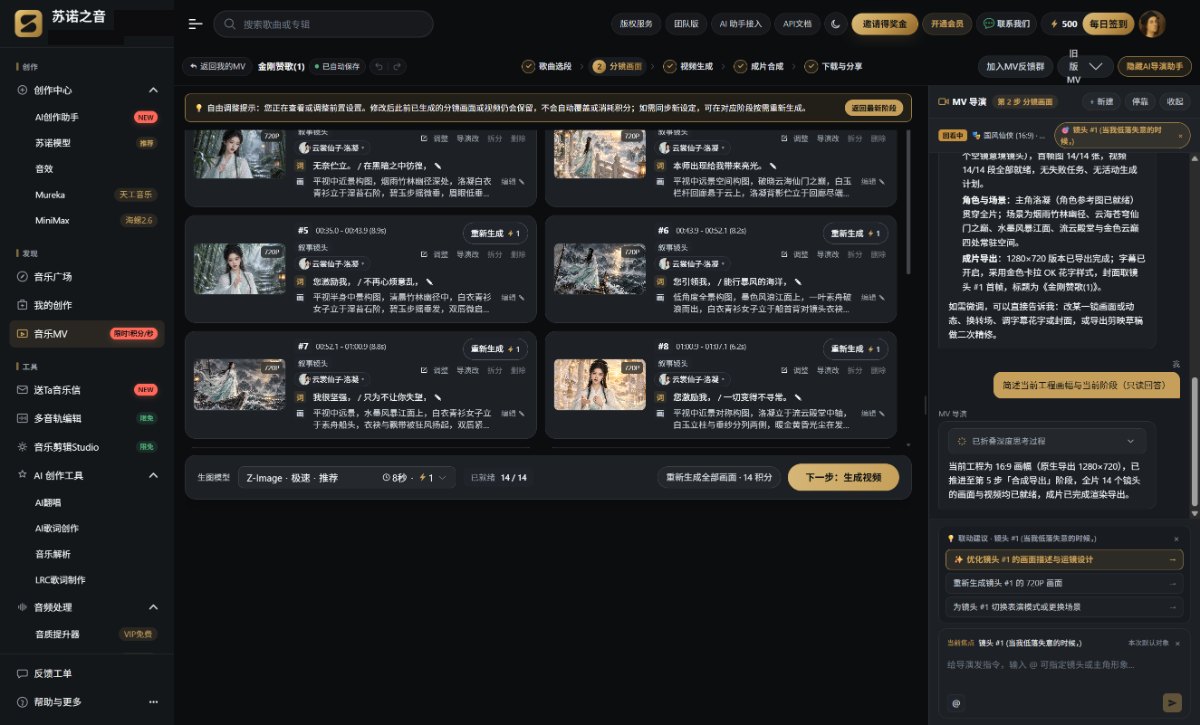
(图:苏诺之音 AI MV 2.0 国风仙侠女主跨竹林、江舟、云海多场景连续分镜一致性实拍)
第三层:分镜首尾双帧锚定与光流平滑转场
为了消除镜头切换瞬间的视觉跳切感,苏诺之音在相邻分镜交界处引入了首尾双帧约束(First-Last Frame Conditioning)。无论是写实国风还是双角色 3D 盲盒潮玩风格(如男童 Leo 与精灵 Momo 跨 27 镜互动),前一个分镜的尾帧与后一个分镜的首帧均在潜空间内进行色彩匹配与平滑过渡,确保整支 MV 从前奏到尾奏的色调呼吸感自然连贯。
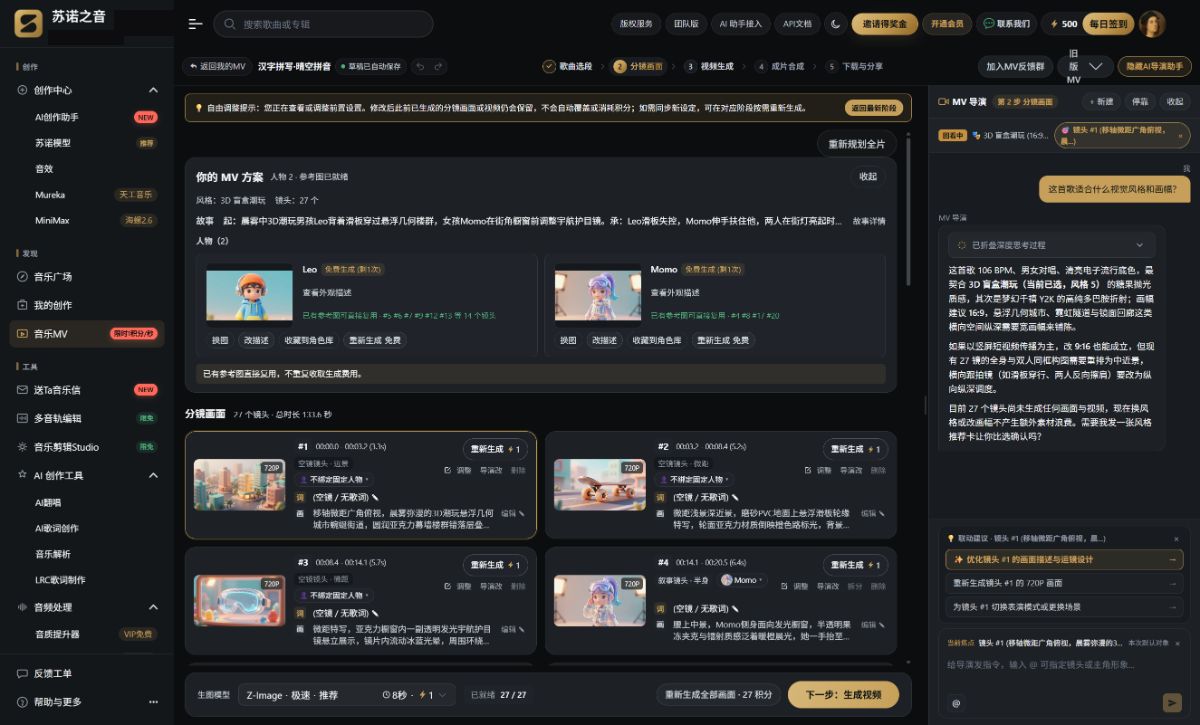
(图:苏诺之音 AI MV 2.0 双角色3D盲盒潮玩风格跨镜头特征锁定关键帧序列)
三、 技术红利转化为极致性价比:10 元以内搞定整支电影感 MV
对比表明,传统基于 LoRA 微调的角色固定方案需要用户预先收集数十张图片并耗费数小时训练模型;而苏诺之音的三层 DAG 视觉指纹方案实现了“免训练、秒级特征提取、跨镜头零成本复用”。
这一架构创新直接带来了显著的成本下降。由于免去了反复重绘废片的算力损耗,苏诺之音得以将终端视频渲染价格下调至每秒仅需 5 分钱(0.05 元/秒)。无论是独立音乐人制作新歌首发 MV,还是微短剧团队批量生产主角形象统一的主题曲与宣传片,均可在 10 元人民币以内、10 至 20 分钟之间 一站式产出人物连贯、画质细腻的 24fps 高清成片。
类型:广告 免责声明:以上内容来源于互联网,如有侵权请联系我们删除。