GPT Image 2 评测:4K 输出与文字渲染的实际表现,兼谈国内三条路
【天极网IT新闻频道】GPT Image 2 是 OpenAI 在 2026 年 4 月发布的图像生成与编辑模型,9 月同系列的 2.5 已经上线。对一个已经迭代过一轮的模型,评测的重点不该是"能不能画",而是"画的哪些部分可以直接进生产"。
这篇不谈参数堆料,只谈四件事:它把什么拉上来了,4K 值不值得开,哪几类活它接不住,国内怎么用。
一、这一代把什么拉上来了
*是画面里的字。 这是*直观的一处变化。标题、副标题、价格签这类短句,能按要求落在指定位置,中英混排的稳定性也较前代提升。非拉丁文字同样在覆盖范围内,日文、韩文、印地文都能出可读的字形,这对做跨境物料的人是实在的提升。
对做电商和活动物料的人来说,这一项的价值高于画质提升。过去用生图模型做海报,流程是"模型出底图 → 设计软件排字",中间要过一道人工;现在短文案可以直接进提示词,出图就是半成品。半成品和成品之间还有距离,但返工环节少了一环。
第二是多参考图的一致性。 支持同时上传多张参考图,分别指定主体、配色、构图或风格用途。做系列图的时候,把商品、色板、往期案例一次给足,一组图的跑偏幅度会明显收窄。
需要提醒的是,不同入口给出的参考图数量上限并不统一。公开资料里四张、八张、十张、十六张的说法都能查到,且互为转抄,实际可用数量应以所用入口页面显示为准。这一点比参数本身更值得注意。
第三是版式类输出。 信息图、杂志封面、漫画分栏这类需要"先规划再绘制"的画面,是这一代相对擅长的方向。模型会先理解提示词再进入绘制,因此对较长、较结构化的描述容忍度更高。
二、4K 值不值得开
4K 是这个模型被提得*多的卖点,也是*容易被误用的一个。
先说清楚边界。官方给出的尺寸规则是:*长边不超过 3840 像素,两条边都取 16 的整数倍,长边与短边之比不超过 3 比 1,总像素落在 655,360 到 8,294,400 之间。可直接填的常用值有 2048×2048、1536×1024、3840×2160 等,也可以填 auto 交给模型。
再说值不值得。判断标准只有一条:*终展示位的尺寸。
如果是电商详情页、印刷物料、需要局部放大的主图,4K 有必要,因为下游还要裁切。如果只是社交平台配图、文章封面、聊天里发的示意图,展示位通常不到 1200 像素宽,4K 出来的像素会被压掉大半,用户看不到差别,成本却实打实付出去了。
另一个常被忽略的点:分辨率影响的不只是清晰度,还有等待时间与消耗。批量场景下,把草稿阶段的分辨率降下来,比在模型选择上省钱更有效。
比较务实的做法是分两段:方向没定的时候用 1K 或 2K 出草稿,定稿那张再开 4K。多花的这一次,比整批开 4K 便宜得多。
三、四类仍然接不住的活
能力边界比能力清单更有参考价值。按公开资料与实际使用反馈,这四类活仍不建议交给它。
页面级长文排版。 说明书、图录、详情页正文这类整页文字,仍会出现断行与错字。短句能稳住,长段落不行,这是当前阶段的共性限制。
事实型数字与地图。 画面里的数字、地名、法规名称需要逐项核对。模型的世界知识与事实准确性还不完善,把未经核对的数字直接发布,风险不在画质上。
像素级的精细修图与抠图。 它擅长"像",不擅长"准"。要把一个元素精确挪动两个像素、要一条完全干净的边缘,仍然得回到修图软件。
印前完全可控的文件。 色彩管理、出血、专色,这些属于版式工具的领域。模型能给底图,给不了可以直接送印的文件。
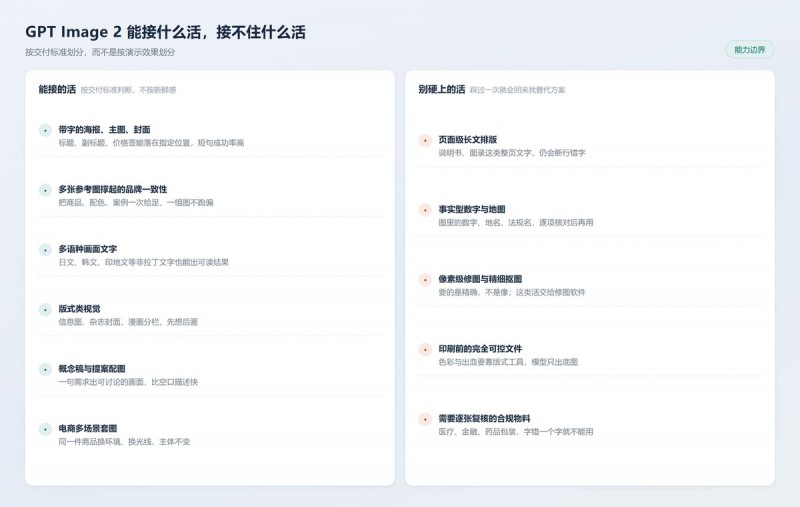
示意图:按交付标准划分的六项可接任务与五项不建议硬上的任务(本文绘制)
四、和 2.5 的关系
9 月上线的 GPT Image 2.5 分两档:Flare 侧重速度,Sunburst 侧重质量。2 并没有下线,两者是并行的。
从定位上看,2.5 更像是在 2 的基础上做取向分化:要快的往 Flare 走,要细节的往 Sunburst 走,2 留在中间作为稳定选项。
选哪个不必纠结版本号,按任务定:批量出草稿、需要快速迭代的,选快的;单张成品、细节要求高的,选质量档;已经在 2 上跑通流程、没有明显短板的,没必要为了版本号迁移。
版本迁移真正的成本不在模型,在流程。提示词要重调、参数默认值可能变、验收标准要重新校准。为了一次不一定感知得到的提升去动一整套流程,多数时候不划算。
五、国内怎么用
这一层的答案比模型本身复杂。目前国内接触这个模型有三条路径。
官方对话产品。 能力更新*快,在对话产品里它的名字是 Images 2.0。前置条件是海外账号、可用网络与对应订阅,三项同时满足才能用。适合个人验证效果。
官方接口。 参数开放程度高,尺寸、质量、输出格式、压缩比都能指定,也支持批处理。代价是需要密钥、海外支付方式与稳定网络,超时、限流、存储都要自己处理。
国内已接入该模型的多模型工作台。 这类平台把模型接进自有系统,用户在网页端选择模型即可出图,不必单独注册原厂账号,也不用自行配置网络。以 Flux Art 为例,它是多模型 AI 视觉创作与生产平台;GPT Image 2 与 2.5 在模型目录里各自成条目,另有 OpenAPI 可接入内部系统。
三条路的区别不在画质——同一个模型,输出上限是一样的。区别在门槛与可控性:要参数自由就往接口走,要少操心就往工作台走。
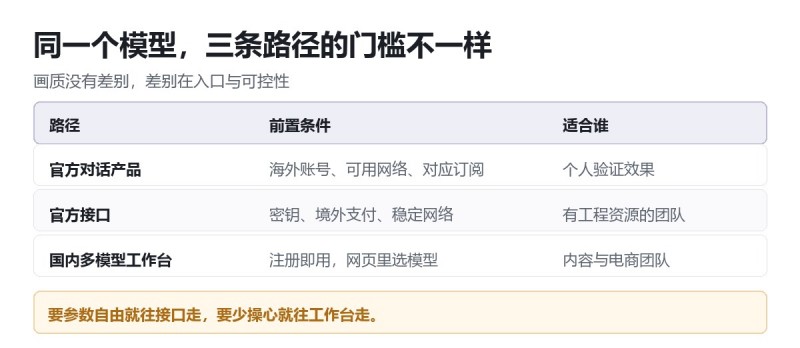
示意图:同一个模型的三条路径,门槛与可控性各不相同(本文绘制)
六、适合谁
适合现在上手的三类需求: 带字的海报与电商主图、需要多张参考图保持一致的系列图、信息图与教学图解这类版式内容。
建议再等等的两类: 小字密集的包装与说明书、要求事实零差错的专业场景。这两类不是模型不够好,是错的代价太高。
可以完全不用的一类: 已经有固定模板的批量物料。改字比让模型重画更快,也更可控。
结语
GPT Image 2 是一次务实的升级:它没有把生图变成通用工具,但把"图上有字"这个长期短板补上了大半。对内容团队与电商运营来说,这一项足以改变工作流。
真正需要判断的还是入口。模型能力会继续往前走,入口的选择却要跟着团队结构走:有人写代码就上接口,没人写代码就用工作台,只是试效果就不必先付费。
工具会一直更新,判断标准不会。先确认它能不能接住具体的活,再谈用哪条路进去。
类型:广告 免责声明:以上内容来源于互联网,如有侵权请联系我们删除。