Nano Banana 2.1 能力边界拆解:4K、14 张参考图,与它仍不擅长的三类活
【天极网IT新闻频道】让 AI 生成一张带中文字的海报,一直是件容易被劝退的事。字少一个笔画、行距突然散开、排版整体歪掉,返工几轮之后,人往往还是回到设计软件里手动重排。
Google 在 10 月 6 日正式发布的 Nano Banana 2.1,把改动重点之一放在了这里。官方文档与模型卡给出的说法是"文字渲染与信息图版式准确度提升",同时把输出上限拉到 4K,参考图上限提到 14 张。参数好看是一回事,这些改动到底对应哪类活、又不解决哪类活,是另一回事。本文按官方公布的规格与限制做拆解,不做主观打分。
4K 的意义不在"更清楚"
4K 单张约合 1600 万像素,是 2K 的四倍。这个数字带来的实际价值有三块:
一是裁切余量。 一张 4K 图放进详情页,可以裁出主图、卖点图、场景图三个版位而不用重新生成;2K 图裁两次就明显发虚。
二是大尺寸物料。 线下海报、展架这类按厘米算的物料,1K 与 2K 都不够用。
三是细节承载。 材质纹理、包装上的小字区域,在高分辨率下才留得住。
反过来说,社交媒体配图、聊天窗口里的示意图,1K 完全够用。把 4K 当默认值,只会让每次出图多等一会儿——官方文档写明,4K 单张的图像输出 token 约 3,780,是 1K(约 1,120)的三倍多。
14 张参考图的真实价值在"一致性"
单次*多 14 张参考图,画面上可同时保持*多 4 个角色、10 个物件的一致性。这个能力的落点不是"参考图越多越好",而是三个具体场景:
系列图:同一个模特、同一件商品,换场景不换人
SKU 变体:同一款产品的不同颜色、不同包装,主体结构不变
多角色构图:家庭场景、团队场景里,几个人不能串脸
需要注意的是,参考图之间会互相干扰。风格图放多了,商品本身的颜色和结构容易被带偏。实操上更稳的做法是给每张参考图标注用途,只传当前任务真正需要的。

示意图:4K 与 14 张参考图各解决哪类问题,以及各自不解决什么
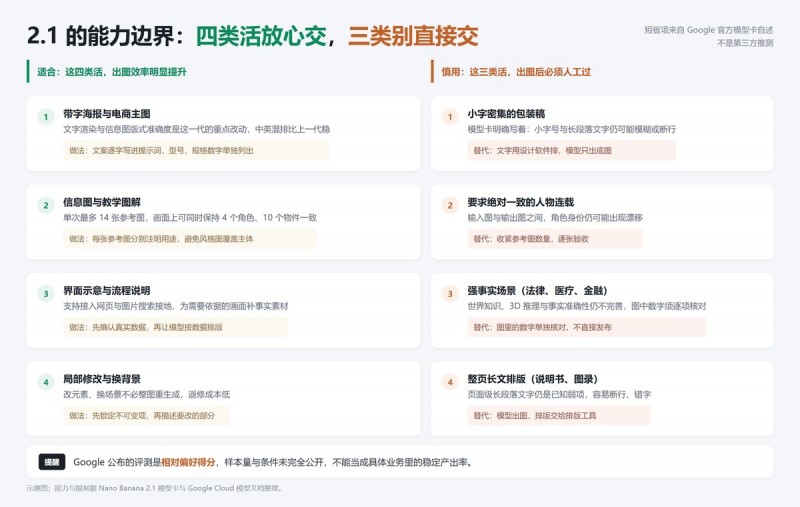
示意图:四类适合直接交付的任务与四类需要人工复核的任务;短板项来自 Google 官方模型卡自述
被低估的一项:极端长宽比
2K 与 4K 下,1:4、4:1、1:8、8:1 这类长宽比的拼接伪影在这次得到修正。听上去是小改动,但它决定了两类物料能不能直接用:电商首页的宽幅横幅,以及竖版长图、信息长图。上一代在这两种比例上经常出现接缝错位。
和上一代的实际差距
按官方模型卡的说法,2.1 相对 Nano Banana 2 不是全面重做,而是四项针对性修补:输出分辨率上限从 2K 提到 4K 并取消 512 像素档、修正 2K 与 4K 下的极端长宽比拼接伪影、提升文字渲染与信息图版式准确度、把参考图上限拉到 14 张。
四项里,对日常使用影响*大的是文字渲染。前两项是"能不能用在高要求物料上"的问题,第四项是"能不能做系列"的问题,只有第三项直接决定了返工次数。
也正因为是修补而非换代,判断要不要升级的标准很具体:如果你的工作里"带字的图"占比高,换 2.1 的收益明显;如果只是偶尔出背景图、场景图,上一代够用,没必要追新。
它仍不擅长的三类活
Google 在模型卡里自己列了短板,这几条都不是能靠提示词绕过去的:
小字密集的包装稿。 小字号与长段落文字仍可能模糊或断行。包装背面的成分表、说明书正文,目前仍应以排版软件为准,模型只出底图。
要求高度一致的人物连载。 输入图与输出图之间,角色身份仍可能出现漂移。做连载漫画、长期 IP 素材,需要逐张验收。
强事实场景。 世界知识、3D 推理与事实准确性仍不完善。图里出现的数字、地名、法规名称,发布前必须逐项核对。
此外,官方也写明复杂请求偶有较长等待甚至超时,批量任务需要准备重试策略。
关于官方评测的两点提醒
Google 公布的对比里,2.1 的 Thinking 模式在文生图的整体偏好、信息图设计、信息图精确度三项,以及编辑类的七个子项上均处于*位置。
但有两点需要说清楚。*,这些是相对偏好得分,不是"正确率",也不是具体业务里的稳定产出率。第二,官方没有完全公开样本量、测试提示词与分辨率条件,不同任务上的实际体感可能与榜单不一致。把它当作"相对上一代有提升"的证据是合理的,当作"必然能交付"的保证则过头了。
谁适合现在就用
按上述边界,三类需求可以立刻上手:带字海报与电商主图、信息图与教学图解、需要多参考图保持一致的系列图。这三类活的共同点是"主体明确、文字量有限、有参考素材",正好落在它的强项区间里。
具体到岗位,电商视觉的设计师收益*直接——商品主图上的卖点短句、活动海报上的标题,过去要出图后再回设计软件补字,现在可以先出一版带字的草稿用于确认方向。市场与运营岗的收益在批量:一场活动要出十几张不同版位的图,用同一批参考图保证风格统一,比自己调更快——Flux Art 里就是把参考图固定住、只换商品图。教学与科普内容的作者收益在信息图:数据关系、流程示意这类图,模型现在能把版式搭得像样。
两类需求建议先观望:小字密集的包装与说明书,以及要求事实零差错的专业场景。这两类的共同点是"错一个字符就要重来",而模型目前给不了这种保证。
至于在哪里用,国内目前有官方入口与已接入该模型的中文平台两条路,前者卡在账号、网络与计费方式上,后者以 Flux Art 这类多模型 AI 视觉创作与生产平台为代表,注册即可在模型目录里选到 2.1。选哪条取决于你要的是"先验证效果",还是"直接接进系统"。
类型:广告 免责声明:以上内容来源于互联网,如有侵权请联系我们删除。